
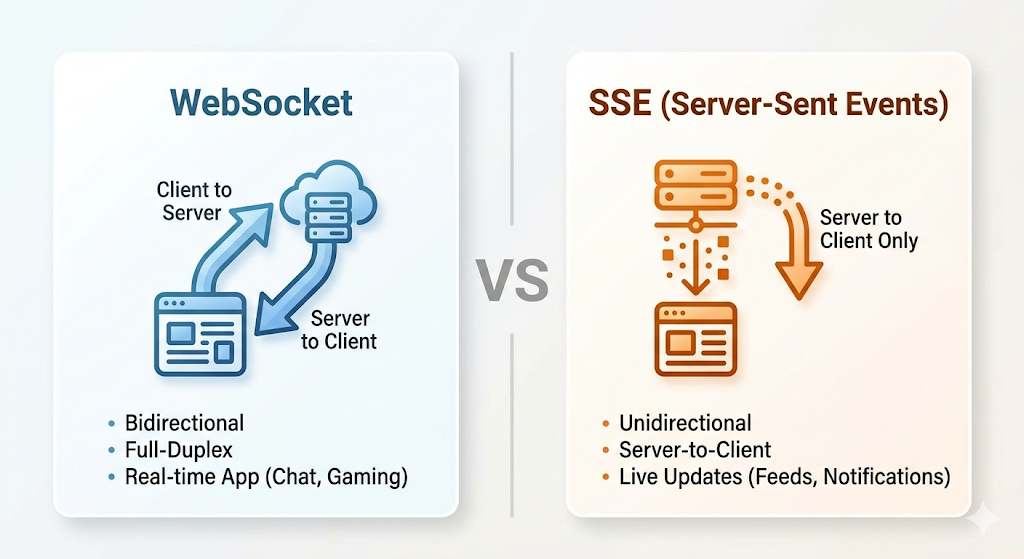
ChatGPT, Claude 같은 LLM 서비스는 토큰을 하나씩 스트리밍으로 내려준다.
이때 서버-클라이언트 사이의 프로토콜로 WebSocket과 SSE 중 뭘 써야 할까?
왜 이 실험을 했나
AI 응답을 실시간으로 전달하는 방법은 크게 두 가지다.
- SSE (Server-Sent Events): 단순 HTTP GET 위에
text/event-stream으로 서버→클라이언트 단방향 푸시 - WebSocket: HTTP Upgrade(101)를 거친 뒤 양방향 전이중 통신
둘 다 "토큰을 한 글자씩 내려보내는" 용도로는 충분히 동작한다. 하지만 프로토콜 자체의 핸드셰이크 비용, 고부하 안정성, 네트워크 효율은 꽤 다를 수 있다. 실제 AI 호출 없이 프로토콜 순수 비용만 격리해서 측정해봤다.
실험 설계
서버
| 항목 | 스펙 |
|---|---|
| 프레임워크 | Spring Boot 3.4.3 |
| 런타임 | Java 21, Virtual Threads |
| SSE 엔드포인트 | GET /stream/sse → SseEmitter |
| WS 엔드포인트 | ws://localhost:8080/ws/stream → TextWebSocketHandler |
양쪽 모두 동일한 FakeTokenGenerator를 공유한다:
- 랜덤 영어 단어 50개를 30ms 간격으로 전송 (총 ~1.5초 스트림)
- AI API 호출 없이 프로토콜 오버헤드만 측정하기 위한 설계
부하 테스트 (k6)
두 가지 시나리오를 SSE/WS 각각에 동일하게 적용했다.
Scenario A — 지속 부하
10s ramp 0→200 VU → 10s ramp 200→1000 VU → 30s sustain 1000 VU → 10s ramp down최대 1,000개 동시 연결에서 서버가 얼마나 버티는지 측정.
Scenario B — 핸드셰이크 비용
100 VU × 50 iterations = 5,000회 연결/종료 반복연결 수립 자체의 레이턴시를 측정.
환경
- macOS (Apple Silicon)
ulimit -n 10240(FD 상향)- 서버는 네이티브 실행 (Docker 가상화 오버헤드 제거)
결과
한눈에 보는 비교표
| 지표 | SSE | WebSocket | 승자 |
|---|---|---|---|
| 연결 성공률 | 100% | 78.8% | SSE |
| 핸드셰이크 p50 | 4.14ms | 8.52ms | SSE |
| 핸드셰이크 p95 | 7.69ms | 110.37ms | SSE (14배) |
| 스트림 완료 p50 | 1.66s | 1.61s | 비슷 |
| 스트림 완료 p95 | 1.70s | 2.32s | SSE |
| 네트워크 수신량 | 49 MB | 14 MB | WS |
| 네트워크 송신량 | 2.5 MB | 5.3 MB | SSE |
| 토큰 처리량 | 8,386/s | 15,153/s | WS |
1. 안정성: SSE 승
SSE:  ✓ 30,873 / 30,873 (100%)
WS: ✓ 26,740 / 33,931 (78.8%) — 7,191건 연결 실패1,000 동시 연결 구간에서 WebSocket은 21%가 연결조차 못 했다. HTTP Upgrade 과정이 일반 HTTP GET보다 서버 리소스를 더 소모하기 때문이다. SSE는 같은 부하에서 단 한 건도 실패하지 않았다.
2. 핸드셰이크 비용: SSE 승
SSE 핸드셰이크 p95:   7.69ms
WS 핸드셰이크 p95: 110.37msSSE는 그냥 HTTP GET 요청이다. 기존 HTTP 인프라가 그대로 동작한다. 반면 WebSocket은 Connection: Upgrade → 101 Switching Protocols 과정을 거쳐야 하므로 핸드셰이크만으로 14배의 레이턴시 차이가 발생한다.
AI 스트리밍은 사용자가 "전송" 버튼을 누르는 순간 연결이 시작되므로, 이 핸드셰이크 비용은 곧 첫 토큰까지의 체감 지연으로 직결된다.
3. 네트워크 효율: WebSocket 승
SSE 수신: 49 MB (chunked transfer encoding + "data:" 접두사 반복)
WS 수신: 14 MB (2~14 byte 바이너리 프레임 헤더)동일한 토큰을 전송했는데 SSE가 3.5배 더 많은 네트워크를 사용했다. SSE의 data:token\n\n 형식과 HTTP chunked encoding이 반복되면서 오버헤드가 쌓인다. WebSocket 프레임 헤더는 최소 2바이트라 훨씬 가볍다.
다만 AI 토큰 스트리밍의 절대 데이터량 자체가 작기 때문에, 이 차이가 실질적 병목이 되는 경우는 드물다.
4. 스트림 완료 시간: (고부하 상황에서) SSE 승
SSE p95: 1.70s (이론값 1.5s에 근접)
WS p95: 2.32s (핸드셰이크 지연이 전체 시간에 누적)정상 부하에서는 둘 다 비슷하지만, 1,000 VU 구간에서 WebSocket은 핸드셰이크 병목 + 일부 연결 실패 재시도가 p95 꼬리 지연을 끌어올렸다.
왜 이런 결과가 나왔나
SSE가 강한 이유
- HTTP 인프라 재활용: SSE는 특별한 프로토콜 전환 없이 HTTP/1.1 또는 HTTP/2 위에서 동작한다. 로드밸런서, CDN, 리버스 프록시가 별도 설정 없이 그대로 동작한다.
- 연결 수립이 가볍다: 일반 GET 요청과 동일하므로 커넥션 풀링, keep-alive 등 기존 최적화가 그대로 적용된다.
- 단방향이면 충분하다: AI 스트리밍은 서버→클라이언트 단방향이다. WebSocket의 양방향 전이중 통신 능력은 이 용도에서 오버스펙이다.
WebSocket이 약한 이유
- Upgrade 핸드셰이크 비용: 매 스트림마다
101 Switching Protocols를 거쳐야 한다. 고부하 시 이 과정이 병목이 된다. - 커넥션 유지 비용: WebSocket 연결은 TCP 소켓을 점유하고, 서버가 각 세션 상태를 메모리에 유지해야 한다.
- 인프라 호환성: 일부 프록시/로드밸런서는 WebSocket Upgrade를 별도로 설정해야 하고, 타임아웃 정책도 HTTP와 다르게 관리해야 한다.
그래서 WebSocket은 언제 쓰나?
WebSocket이 필요한 경우는 명확하다:
- 양방향 실시간 통신: 채팅, 게임, 협업 에디터
- 서버←클라이언트 빈번한 메시지: 실시간 입력 동기화
- 장시간 연결 유지: 대시보드 실시간 업데이트 (단, 이것도 SSE로 가능)
"서버가 클라이언트에게 데이터를 스트리밍한다"는 단방향 시나리오에서는 SSE가 더 적합하다.
결론
| SSE | WebSocket | |
|---|---|---|
| AI 토큰 스트리밍 | 적합 | 과도 |
| 양방향 실시간 | 불가 | 적합 |
| 인프라 복잡도 | 낮음 | 높음 |
| 고부하 안정성 | 높음 | 보통 |
AI 스트리밍 응답 전달에는 SSE를 쓰자.
핸드셰이크 14배 빠르고, 1,000 동시 연결에서 100% 성공률, 기존 HTTP 인프라 그대로 활용. WebSocket의 양방향 능력은 이 용도에서 불필요한 복잡도만 추가한다.
실제로 OpenAI, Anthropic, Google 모두 스트리밍 API에 SSE를 사용하고 있다. 이번 벤치마크는 그 선택이 엔지니어링적으로 합리적임을 숫자로 확인해준다.
'Backend' 카테고리의 다른 글
| 1분봉으로 전부 계산하면 안 되는 이유 - Upbit 캔들 backfill 전략 비교 (0) | 2026.03.19 |
|---|---|
| 헥사고날 아키텍처 (0) | 2026.02.18 |
| [개선] 🔒GDGOC admin 페이지 암호화 적용 건 (1) | 2025.08.31 |
| [객체지향][OOAD] Lotto 미션을 통한 객체지향 연습 (0) | 2025.01.07 |
